Ключевое отличие серии EPYC 9006 (Venice) — поддержка до 256 ядер на один сокет, что превышает показатель предыдущего поколения EPYC 9005 (Turin) на треть, при этом IPC вырос на 20 %, а тактовые частоты поднялись. Среди новшеств — обновлённая подсистема ввода-вывода PCIe 6.0 и более чем двукратный рост пропускной способности памяти. Стоит также выделить переработанную микроархитектуру Zen 6 и модернизированную архитектуру системы на кристалле (SoC).
Помимо этого, AMD разбила линейку на несколько семейств под разные задачи, задействовав два основных типа сокетов. Возвращаются модели с расширенным кешем (Venice-X), а также появилась версия Verano с поддержкой памяти LPDDR5X. Новая серия покрывает существенно более широкий круг сценариев и является, пожалуй, самым смелым шагом в эволюции линейки EPYC с момента перехода на архитектуру с отдельным кристаллом I/O — решение, которое обеспечило процессорам EPYC 7002 (Rome) настоящий прорыв.
Изображения предоставлены компанией AMD
В основе процессоров EPYC 9006 лежат архитектуры Zen 6 и Zen 6c. Они во многом схожи и не нуждаются в отдельной программной адаптации для совместной работы, однако предназначены для различных рыночных ниш и приоритетов по производительности.
Ядра Zen 6c созданы с упором на максимальную плотность размещения и занимают меньшую площадь кристалла, в то время как Zen 6 нацелены на более высокие тактовые частоты. У компактных ядер Zen 6c нет поддержки 3D V-Cache, а частоты заметно ниже, чем у стандартных Zen 6 — именно это дало возможность уместить больше ядер на ограниченной площади кремния.
Сначала заявлялось, что топовый чип EPYC 9686F будет иметь пиковую частоту 5,0 ГГц, однако в реальности она оказалась выше — 5,3 ГГц. Практически вся линейка процессоров для сокета SP7 получила прибавку к тактовой частоте — примерно на 100 МГц относительно предварительных спецификаций AMD.
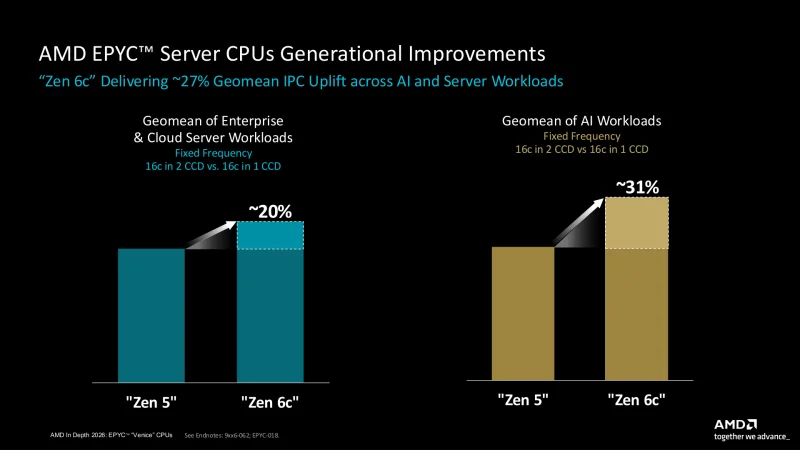
AMD обещает, что в микроархитектуре Zen 6 показатель IPC вырастет на 20 % относительно Zen 5. В зависимости от конкретной рабочей нагрузки такой прирост IPC в корпоративных (серверных) сценариях может стать одним из наиболее значительных улучшений за всю историю микроархитектуры Zen.
Ещё более внушительный рост IPC — на 31 % — заявлен для задач, связанных с искусственным интеллектом. Этого удалось достичь за счёт доработок в системе команд (ISA) Zen 6: производитель ввёл новые инструкции, которые особенно результативны при выполнении ИИ-нагрузок.
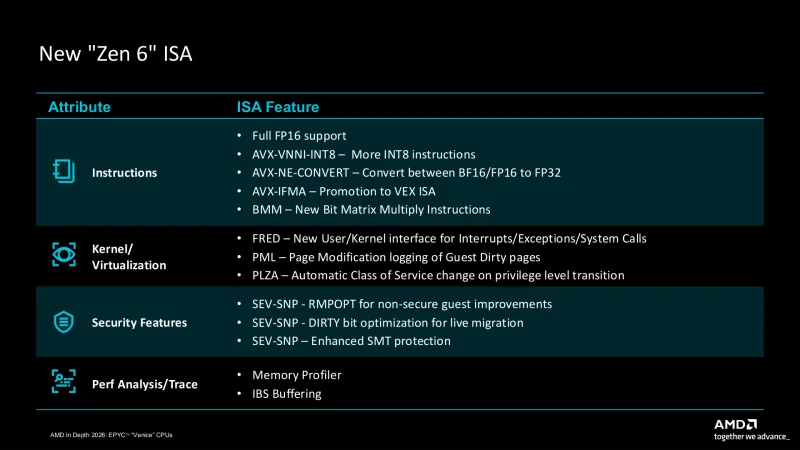
В дополнение к этому, реализованы новые AVX-инструкции для INT8, конвертации форматов и целочисленные FMA-операции — решение, которое впервые было внедрено компанией Intel. Помимо этого, AVX-блоки теперь полностью поддерживают формат FP16. Это означает, что Zen 6 способен выполнять ресурсоёмкие вычисления с FP16 с той же производительностью, что и операции с FP32 и FP64. Кроме того, AMD расширила набор инструкций AVX-512 новой командой для матричного умножения битовых данных, что даст дополнительное ускорение при выполнении специализированных побитовых матричных операций.
Также был внедрён ряд прочих новых инструкций, которые не оказывают прямого влияния на производительность и ориентированы на иные задачи. К ним относятся три новые инструкции уровня ядра (kernel instructions), предназначенные для виртуализации; наиболее заметной из них является FRED (Flexible Return and Event Delivery — «гибкий механизм возврата и доставки событий») — новый для AMD интерфейс, обеспечивающий переходы между различными уровнями привилегий ядра.
Помимо этого, для разработчиков, которые стремятся максимально полно использовать возможности чипов на архитектуре Zen 6, AMD подготовила несколько новых инструментов. В частности, стоит отметить появление буферизации для механизма выборки на основе инструкций (instruction-based sampling). Также было уделено внимание работе с памятью: добавлен новый профилировщик памяти.
Важно подчеркнуть, что основной акцент делался не на увеличении вычислительных мощностей, а на оптимизациях, дающих возможность продуктивнее задействовать уже имеющиеся аппаратные блоки и достигать более высокого значения IPC за счёт обработки расширенного окна инструкций.
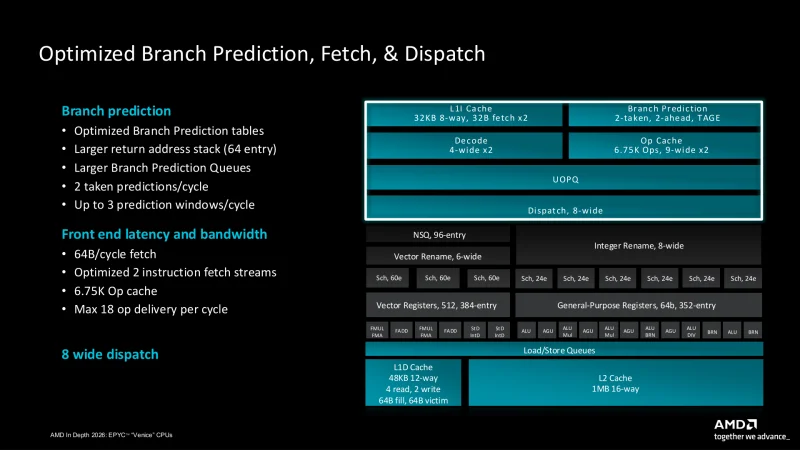
Речь идёт об увеличенном кеше микроопераций (Op-cache), расширенном стеке адресов возврата, более ёмких планировщиках для целочисленных вычислений и операций с плавающей запятой (FP/INT), а также о ряде других улучшений. В частности, общий объём кеша микроопераций вырос с 6 тыс. до 6,75 тыс. инструкций (прирост 13 %), а пропускная способность — с 12 до 18 операций за такт (вместо прежней схемы «2 блока по 6 инструкций» теперь применяется конфигурация «2 блока по 9 инструкций»). Что касается планировщика инструкций, радикальных изменений здесь не произошло, однако разработчики сосредоточились на механизме планирования целочисленных операций.
Ширина конвейера сохранена на уровне 8 операций за такт на этапах переименования (Rename), диспетчеризации (Dispatch) и завершения (Retire), унаследованных от архитектуры Zen 5. При этом планировщик разделён на 6 отдельных блоков, каждый из которых вмещает 24 инструкции; таким образом, AMD перешла к распределённой стратегии планирования. Эти 6 блоков неодинаковы: 2 из них (48 записей) предназначены исключительно для операций ALU, а остальные 4 (96 записей) являются общими — они задействуются как для арифметических операций, так и для генерации адресов (AGU). Для сравнения: в архитектуре Zen 5 планировщик AGU имеет фиксированный размер в 56 записей, а планировщик ALU — 88 записей.
При этом суммарное число слотов, выделенных только для ALU, уменьшилось — благодаря этому планировщик AGU может задействовать большую часть окна планирования тогда, когда это даёт наибольший эффект. Данная корректировка призвана не просто увеличить объём планируемых инструкций, но и сделать сам процесс планирования более гибким, что позволило снизить простои аппаратных ресурсов.
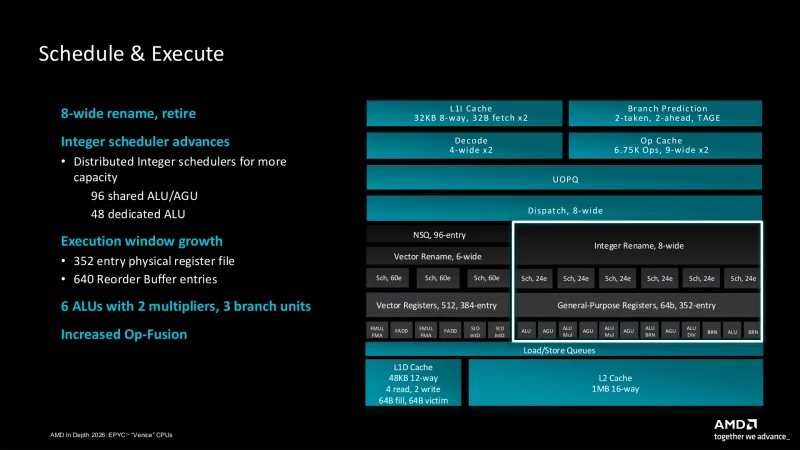
Кроме того, был увеличен буфер инструкций. Очередь переупорядочивания (ROB) в Zen 6 выросла с 448 до 640 элементов (+43 %). Это даёт возможность выявлять больше параллелизма на уровне команд за счёт анализа более протяжённых последовательностей инструкций. Одновременно снизилась борьба между инструкциями за физические регистры (PRG) — число записей в PRG-файле увеличено с 240 до 352 (+47 %). По словам AMD, также были внесены изменения, позволяющие чаще объединять операции внутри процессорного ядра, хотя конкретные детали этих доработок не раскрываются.
В FPU-блоке по-прежнему задействованы три планировщика инструкций, размещённые после блока переименования регистров (способного обрабатывать 6 инструкций за такт), однако теперь ёмкость каждого из этих планировщиков составляет 60 записей — против 32 в архитектуре Zen 5. Хотя AMD не добавила в бэкенд процессоров Zen 6 новые конвейеры, компания внесла ряд корректировок, изменив распределение типов инструкций, которые могут обрабатываться каждым из конвейеров.
В части AVX/ИИ: теперь четыре ALU-конвейера способны исполнять инструкции VNNI-INT8 — вдвое больше, чем у Zen 5. При этом конвейеров с поддержкой INT16 и BF16 осталось два, то есть улучшение нацелено прежде всего на INT8-операции. При этом базовые параметры исполнительных конвейеров (backend), включая число каналов для стандартных fused-инструкций и их задержки (latency), не претерпели изменений.
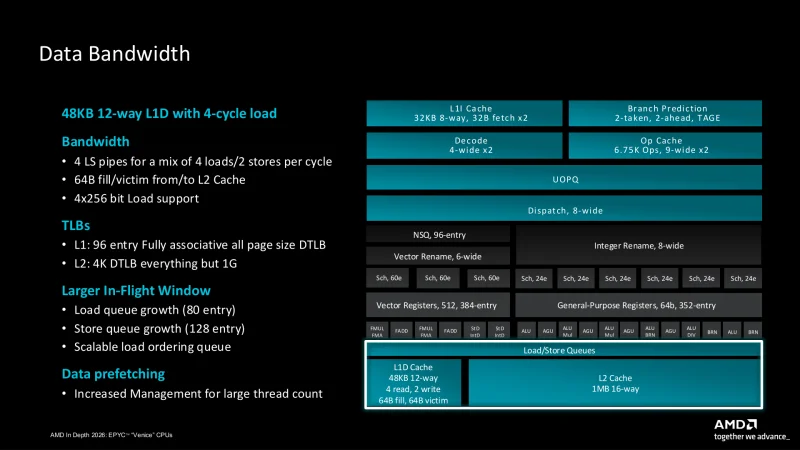
Для их функционирования предусмотрены модернизированные блоки загрузки/сохранения (load/store units) и буферы трансляции (TLB). AMD сохранила четыре канала загрузки/сохранения, обрабатывающих до четырёх операций загрузки либо двух операций сохранения за такт. Теперь система может выполнять четыре операции загрузки за такт при условии, что размер каждой равен 256 битам (у Zen 5 — две операции). В прочем общая пропускная способность осталась на уровне 1024 бит за такт — столько же было у Zen 5 при выполнении 512-битных операций загрузки (2 × 512 бит).
Кроме того, расширены буферы для операций загрузки и сохранения: очередь загрузки увеличена с 64 записей в Zen 5 до 80, а очередь сохранения — со 104 до 128 записей. Кеш данных первого уровня L1 остался таким же, как у Zen 5: его объём равен 48 Кбайт, ассоциативность составляет 12 каналов, а задержка при выполнении загрузки — 4 такта. Пропускная способность между разными уровнями кеша также осталась прежней — заполнение кеша L1 происходит со скоростью 64 байта за такт, а кеш L2 получает данные из L3 со скоростью 32 байта за такт.
Ранее мы уже упоминали, что AMD существенно нарастила кеш L3 в компактных чиплетах. Теперь каждый вычислительный кластер CCD архитектуры Zen 6c оснащается 4 МБ кеша L3 на ядро — идентичный показатель демонстрируют CCD поколений Zen 5 и Zen 6. Кроме числа ядер и площади кристалла, единственным заметным отличием между двумя вариантами CCD остаётся пиковая проектная частота, и разрыв по этому параметру тоже уменьшается. У компактных CCD Zen 6c максимум достигает 4,1 ГГц (у предшествующего поколения было 3,7 ГГц), тогда как CCD Zen 6 работает на 5,3 ГГц. Заодно вдвое выросло число ядер в одном CCD — с 16 у Zen 5c до 32.
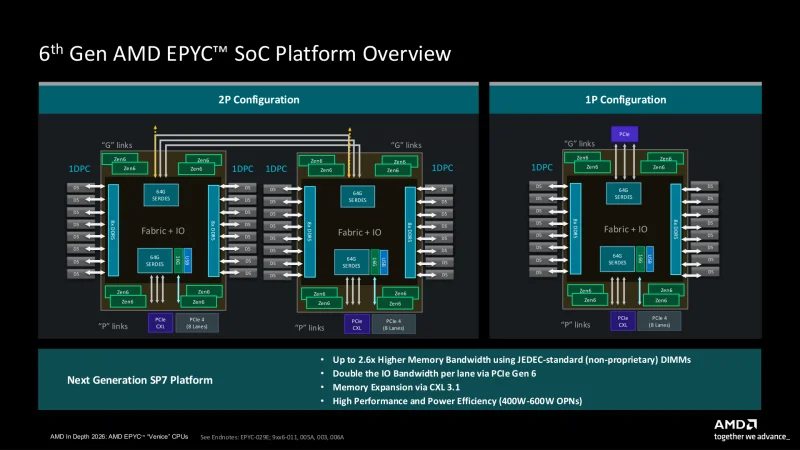
Претерпел изменения и кристалл ввода-вывода — I/O Die (IOD). В его состав входят контроллеры памяти, контроллеры PCIe, модуль безопасности (RoT), а также интерфейс Infinity Fabric (XGMI), который обеспечивает выделенный канал связи с серверными ускорителями AMD. Общая концепция IOD сохранилась, однако AMD спроектировала полностью новый кристалл, выпускаемый по 6-нм техпроцессу TSMC. Благодаря этому платформа Venice обзавелась набором новых технологий, дающих вычислительным ядрам Zen 6 все необходимые ресурсы ввода-вывода.
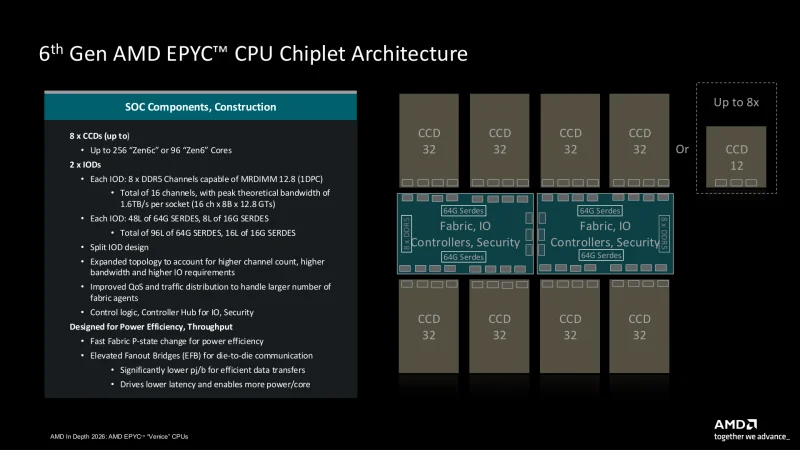
Ключевое новшество — разделение IOD на два отдельных кристалла. В отличие от IOD, применяемых в процессорах Turin, в IOD платформы Venice SP7 была усовершенствована подсистема памяти. Хотя отрасль в целом продолжает использовать DDR5, AMD создала для Venice значительно более производительный и быстрый контроллер памяти. Новый IOD обеспечивает поддержку 8 каналов DDR5 с пропускной способностью до 8000 МТ/с либо модулей памяти MRDIMM второго поколения со скоростью 12 800 МТ/с (в конфигурации 1DPC). Это первая платформа AMD с поддержкой MRDIMM. Таким образом, по сравнению с Turin, пропускная способность памяти на один канал удвоилась.
Благодаря размещению двух кристаллов IOD в едином корпусе, чип Venice SP7 получает суммарно 16 каналов памяти. В максимальной конфигурации это даёт пропускную способность 1,6 Тбайт/с на сокет при поддержке до 8 Тбайт ОЗУ. При этом AMD официально предусматривает только режим 1DPC, так что конфигурации с 32 модулями DIMM для Venice SP7 не реализуются.
В этом поколении также пересмотрено предельное число кристаллов CCD, которое может обслуживать один IOD. Если Turin допускал размещение 16 CCD, то в Venice один IOD поддерживает максимум 4 таких кристалла, что в сумме составляет 8 CCD на процессор. Соответственно, AMD повысила скорость обмена данными между IOD и CCD, чтобы обеспечить стабильную работу увеличенного количества вычислительных ядер. В частности, на каждые 8 ядер процессора приходится один порт SDP (Scalable Data Port) с пропускной способностью 32 байта за такт.
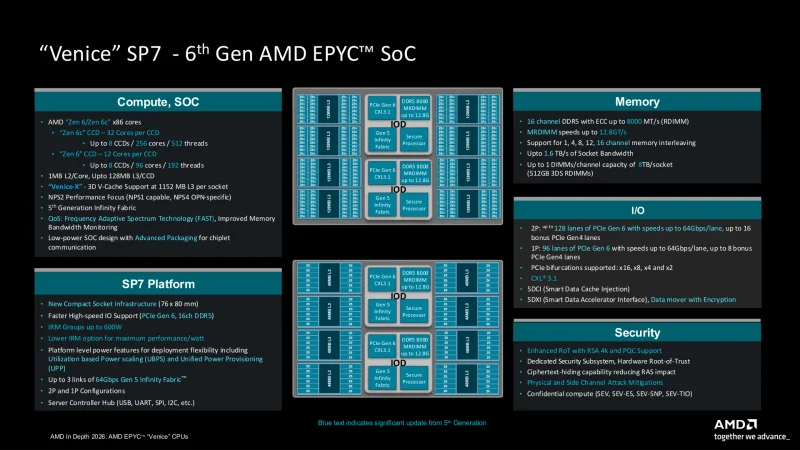
В части внешних подключений новый IOD демонстрирует заметный рост пропускной способности интерфейсов за счёт поддержки спецификаций PCIe 6.0 и CXL 3.1. Каждый кристалл IOD в процессоре Venice SP7 содержит 48 блоков 64G SERDES, обеспечивающих функционирование обновлённых линий PCIe, а также 8 блоков 16G SERDES для иных задач. В сумме это обеспечивает чипу с разъёмом SP7 до 96 линий PCIe 6.0, плюс 8 «дополнительных» линий PCIe 4.0 для прочих потребностей.
Помимо этого, AMD серьёзно переработала технологию корпусирования, применяемую для объединения CCD и IOD, отказавшись от классических органических подложек (2D-компоновка) в пользу сочетания метода 2,5D-упаковки Elevated Fan-out Bridge (EFB) и кремниевых мостов.
Теперь кристаллы IOD подсоединяются к CCD через компактные кремниевые мосты (аналог EMIB от TSMC), за счёт чего CCD размещаются вплотную к IOD. Близкое расположение кристаллов и передача сигналов через кремниевый интерпозер дали AMD возможность заметно сократить энергозатраты (в пересчёте на пДж/бит) при обмене данными между кристаллами. Кроме того, это снижает задержки благодаря уменьшению расстояния и применению более быстрого интерконнекта. Впрочем, с другой стороны, это усложняет корпусирование и увеличивает связанные с ним расходы.
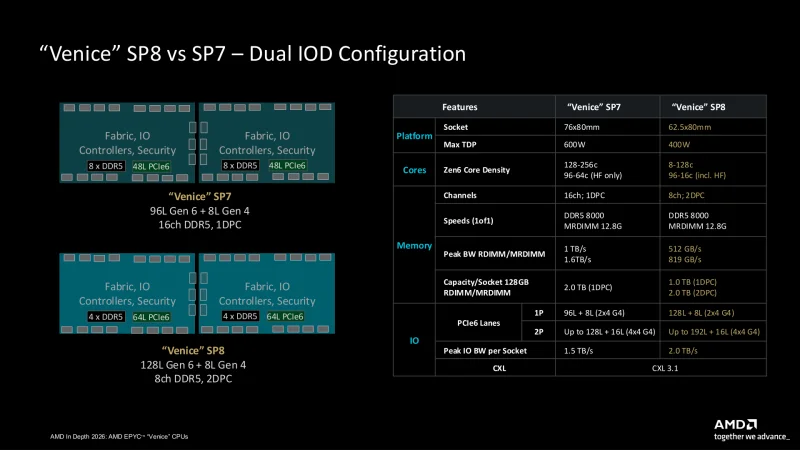
Для Venice с разъёмом SP8, в свою очередь, создали отдельный, более компактный кристалл IOD, который, невзирая на уменьшенные габариты, также вместил два кристалла в одном корпусе. При этом упомянутый IOD спроектирован с меньшим упором на пропускную способность памяти и с бо́льшим акцентом на пропускную способность внешних интерфейсов I/O. В Venice SP8 число каналов DDR5 уменьшено с 16 до 8, что вдвое снижает пропускную способность памяти, однако даёт возможность задействовать конфигурацию 2DPC (правда, совокупный объём остаётся тем же, что и у Venice SP7). Равным образом поддерживаются модули DDR5-8000 RDIMM и DDR5-12800 MRDIMM (1DPC).
Снижение пропускной способности памяти в Venice SP8 возмещается за счёт роста числа линий PCIe. Каждый чиплет IOD обеспечивает 64 линии PCIe 6.0/CXL 3.1, что в односокетной (1S) конфигурации даёт в общей сложности 128 линий. Это на 32 линии (2 root-порта) больше, чем у Venice SP7. Иными словами, интерфейс CXL 3.1 с поддержкой PCIe 6.0 масштабируется до 96 линий на сокет в системе SP7 и до 128 линий на сокет в системе SP8. При этом каждая конфигурация x16 обеспечивает «сырую» пропускную способность вплоть до 128 Гбайт/с при задержке, равной одному переходу в рамках архитектуры NUMA.
Платформа Venice SP7 допускает как одно-, так и двухсокетную конфигурацию. Как и в случае с поколением Turin, переход к двухсокетной схеме требует выделения части линий PCIe от каждого процессора: они переназначаются в качестве линий xGMI, обеспечивающих обмен данными между двумя процессорами. При таком объединении двух чипов обычно задействуется по 32 линии PCIe от каждого из них. В итоге для подключения периферийных устройств остаётся 128 линий PCIe 6.0 (по 64 линии на каждый процессор).
Кроме того, можно повысить пропускную способность канала между чипами Venice SP7, пожертвовав ещё одним блоком из 16 линий PCIe (то есть третьим root-портом). Это позволяет довести эквивалентную пропускную способность канала между процессорами до уровня 48 линий PCIe/xGMI, оставляя 96 линий (по 48 на каждый процессор) для прочих задач I/O.
Из-за нехватки памяти и роста её цены платформа Venice применяет набор технологий управления памятью, которые помогают операторам сократить расходы, связанные с DRAM. Прежде всего, реализована поддержка стандарта CXL: в актуальной версии 3.1 он открывает широкие возможности для наращивания объёма памяти. Операторы могут задействовать уже имеющиеся у них модули DDR4 и DDR5 RDIMM, устанавливая их в специализированные расширители CXL, что позволяет увеличить суммарный объём памяти, доступной серверу. Для той же цели используются наработки компании MEXT, приобретённой AMD в июне: они дают возможность с помощью программных средств эффективно расширить доступный объём памяти.
Материалы по теме:
- IBM, AMD и ORNL запустили платформу для разработки технологий квантовой коррекции ошибок
- Ядра RISC-V пропишутся в чипах AMD Zen 6 — для TEE и PSP
- Квартальная выручка AMD в ЦОД-сегменте взлетела вдвое
- Авиасообщение в США, наконец, перестанет зависеть от дискет
- Broadcom вспомнила о небольших компаниях и выпустила VMware vSphere Express с поддержкой до 128 ядер
Источник:
- amd.com